1. Reward
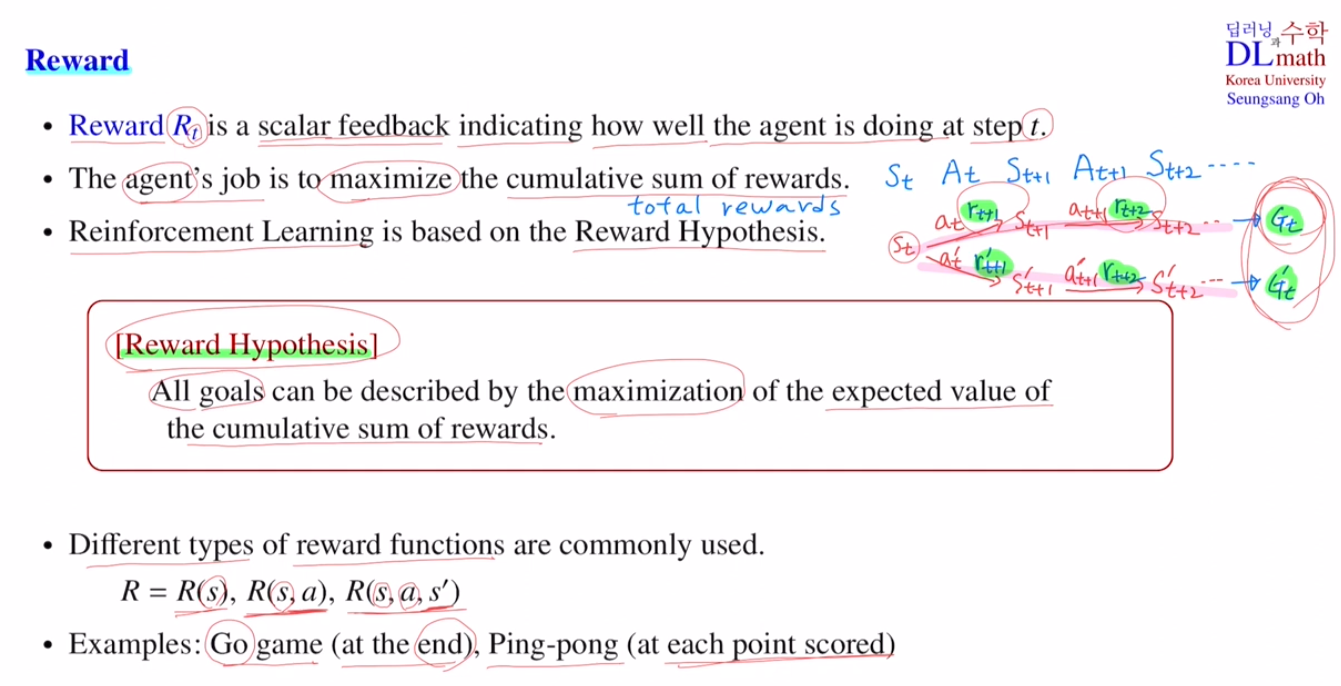
- Reward 는 단계(present time step)에서 agent의 수행 정도를 평가하는 scalar feedback이다.
- Agent의 임무는 total reward를 maximize 하는 방향으로 학습하는 것이다.
- 또한, RL은 **Reward Hypothesis**에 기반을 두고 있다.
1-1. Reward Hypothesis
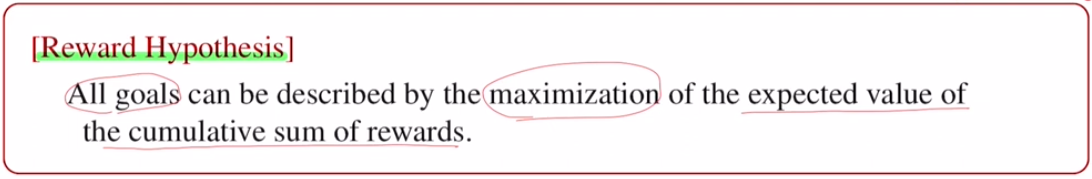
- RL에서 모든 목표는 임의의 stochastic policy에서 나타날 수 있는 각각의 episode에 대한 total reward(cumulative sum of reward)들의 기대값(expected value)을 maximize 하는 방향으로 agent를 학습해야 한다.
- 이것이 RL의 가장 기본적인 방향이 된다.
1-2. Reward function
일반적으로 다양한 유형의 reward function이 사용된다.
e.g. 바둑(Go game) : 한 게임(episode)가 끝나면 승자에게 보상이 주어짐
| | 현재 state에 대한 reward | | | 현재 state 에서 어떤 action 를 취했을 때 얻는 reward | | | 현재 state 에서 어떤 action 를 취해서 로 전이될 때 얻는 reward |
2. Expected Reward
2-1. Dynamics
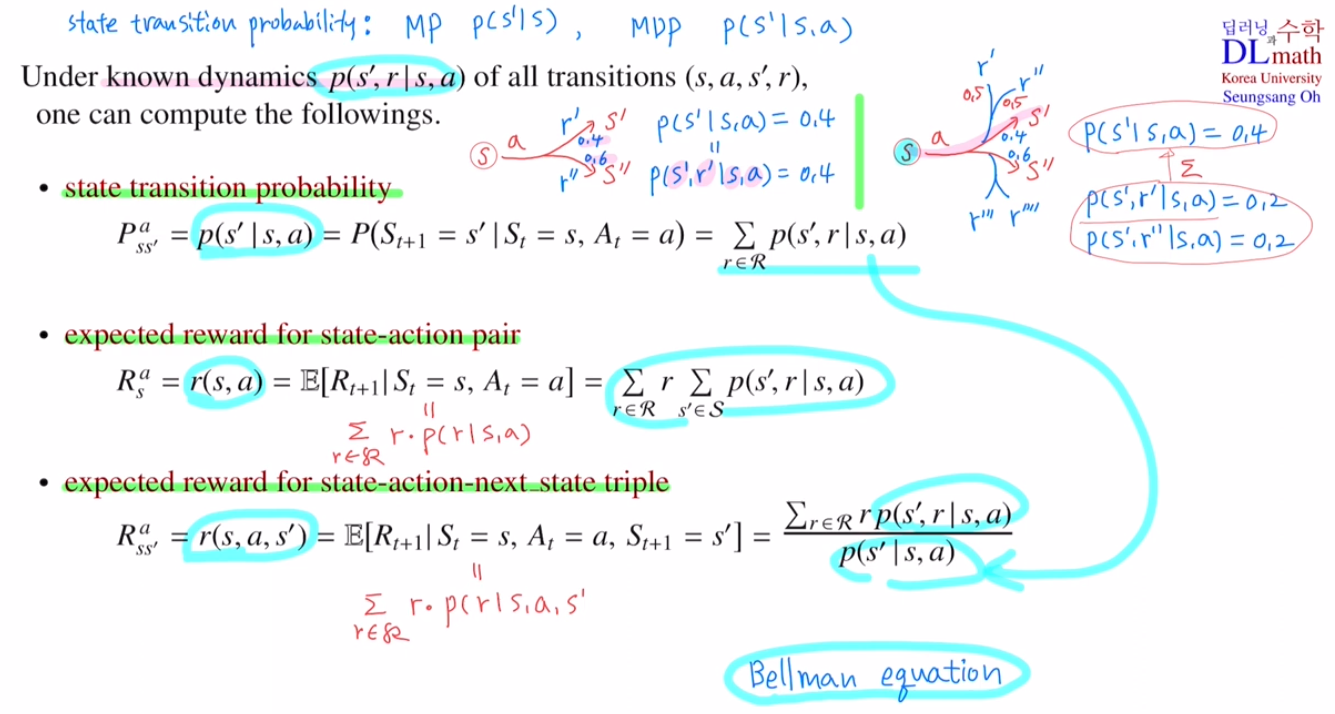
- Agent가 environment와 상호작용할 때, 특정 state에서 특정 action을 취했을 때 환경이 어떻게 변화할지를 결정하는 물리적 법칙이나 규칙을 의미한다.
- Dynamics는 수학적으로 transition probability나 transition function으로 정의된다.
MDP model example 1
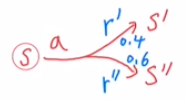
- 현재 state 에서 action 를 취했을때, 다음 state가 일 확률
- 현재 state 에서 action 를 취했을때, 다음 state가 이고, reward 을 받을 확률
MDP model example 2 (Dynamic programming)
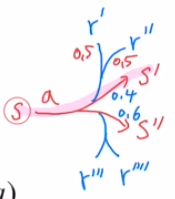
- 현재 state 에서 action 를 취했을때, 다음 state가 일 확률
- 현재 state 에서 action 를 취했을때, 다음 state가 이고, reward 을 받을 확률
- 현재 state 에서 action 를 취했을때, 다음 state가 이고, reward 을 받을 확률
2-2. State transition probability
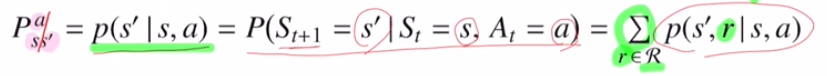
2-3. Expected reward for state-action pair
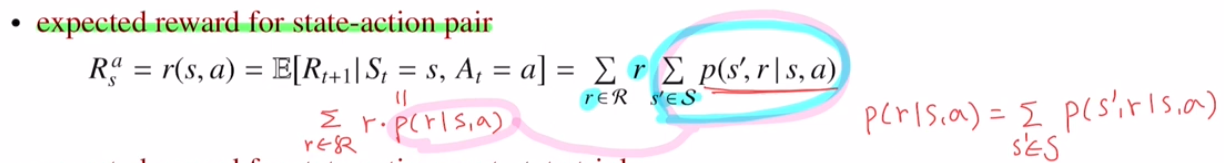
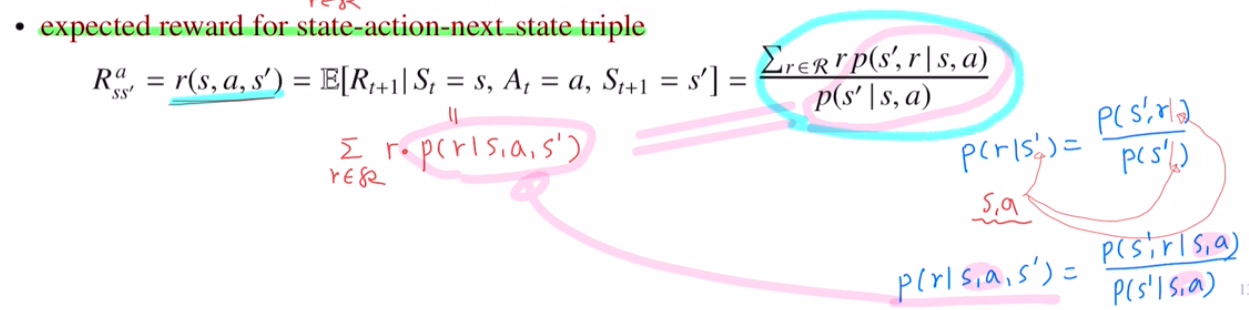
2-4. Expected reward for state-action-next state triple
3. Return
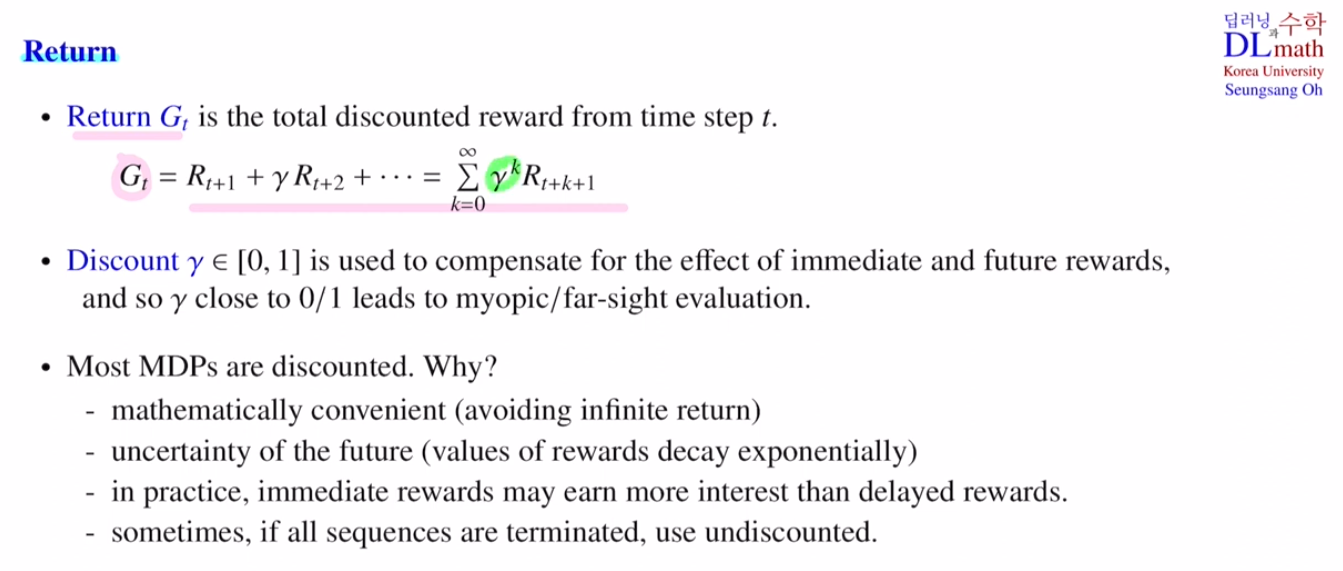
3-1. Return
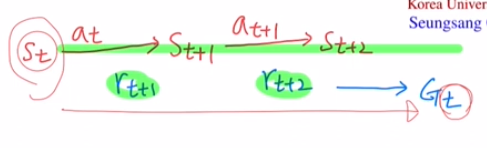
- Return 는 현재 time step 이후에 받게 될 total discounted reward 이다.
3-2. Discount factor
- 할인율 또는 감가율 이라고 불리며, 0 ~ 1 사이의 값을 갖는다. ( )
- 가 0에 가까우면, 미래 reward에 곱해지는 가 빠르게 0이 되므로, 당장 받는 보상(immediate rewards)에만 신경 쓰게된다. (myopic, 근시안적)
- 가 1에 가까우면, 미래 reward도 거의 깎이지 않고 그대로 반영되므로, 먼 미래에 받게될 보상(future rewards)도 고려한다. (far-sight, 멀리 내다봄)
3-3. MDP에서 discount factor를 사용하는 이유
수학적 편리함
- continuing task에서 이면 expected total reward가 발산하지 않고 유한하게 수렴한다.
미래의 불확실성
- 일반적으로는 stochastic policy를 사용하므로, 먼 미래일수록 불확실성을 가진다. 그래서 그만큼 discount factor를 지수적으로 낮춘다.
즉각 보상 선호
- 현실에서도 즉각적인 보상(immediate reward)이 지연된 보상(delayed reward)보다 선호되는 경향을 반영한다.
유한 종료 시 생략 가능
- 모든 episode가 finite time에 끝난다면, discount factor를 사용하지 않기도 한다.
4. Policy
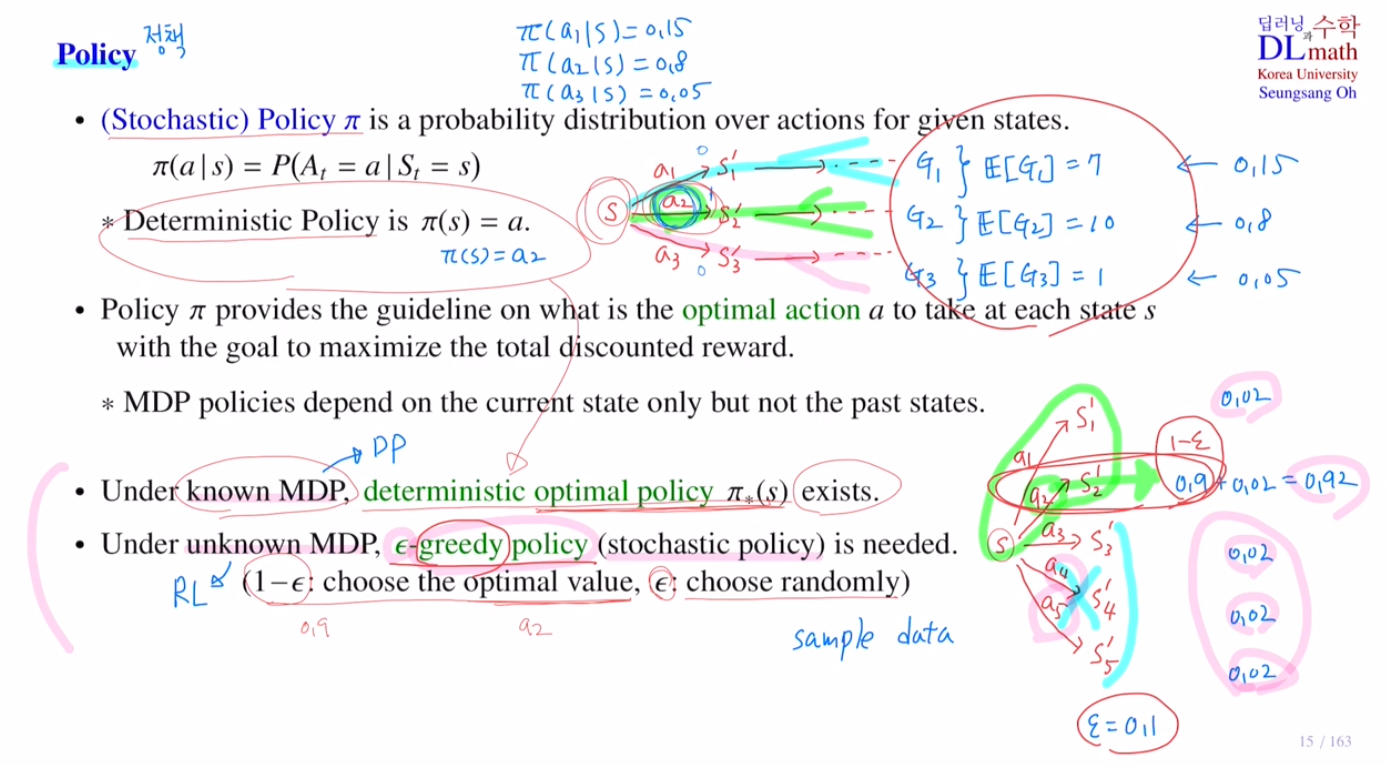
4-1. Deterministic policy
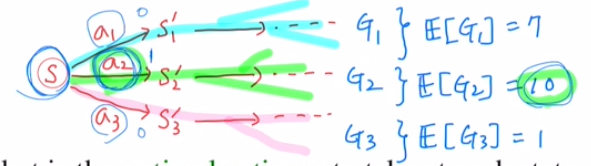
- 결정적 정책은 주어진 state에 대해 하나의 action을 확정적으로 대응시킨다.
- 위 이미지 에서는 return이 가장 큰 action인 를 확정으로 선택하였다.
4-2. Stochastic policy
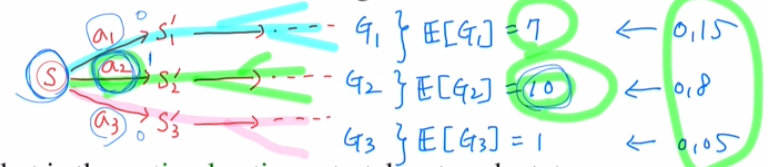
- 확률적 정책은 주어진 state에 대한 action들의 확률 분포(probability distribution)이다.
- 위 이미지 에서는 각 action에 대해 return을 참고하여 확률을 분포하였다.
4-3. Policy의 역할
- Return(= total discount reward) 값을 maximize 하는 것
- 이를 위해서는 각 state 마다 어떤 action을 취하는 것이 좋은지(optimal action) 알려주는 가이드 라인
- 단, Markov property에 의해 다음 state로의 transition probability는 오직 현재 state에만 의존하고, 그 이전의 과거 state와는 무관하다.
4-4. Known MDP (Model-based)
- transition probability를 알고 있기 때문에 expected reward에 대한 계산이 가능하다.
- 따라서, known MDP의 경우에는 deterministic optimal policy 를 찾을 수 있다.
- e.g. Dynamic programming → known MDP를 이용해서 deterministic optimal policy를 찾는 문제
4-5. Unkown MDP (Model-free)
- 경험(sample data)과 같은 한정적인 정보만 알고 있다.
- transition probability를 모르기 때문에 ** policy(stochastic policy)**를 사용한다.
- e.g. Reinforcement Learning
4-6. policy (stochastic policy)
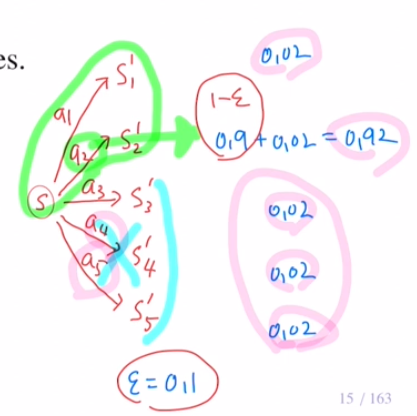
- 미래를 생각하지 않고 각 단계에서 가장 최선의 선택을 하는 기법
- 즉, 각 단계에서 최선의 선택을 한 것이 전체적으로 최선이길 바라는 알고리즘
- 추후 RL 에서 다시 보도록 한다.
- , action 5개
- 위 예제 model에서 **초록색**은 알고 있는 샘플 데이터, **파란색**은 **모르는 데이터**라고 가정한다.
- sample data를 이용해서 학습한 결과, 의 expected total reward가 가장 크므로 를 best action으로 본다.
⇒ : choose the optimal value(greedy), : choose randomly
값을 모든 action에 균등 배분
Best action 의 action select probability
나머지 action들의 action select probability
5. Summary of notation
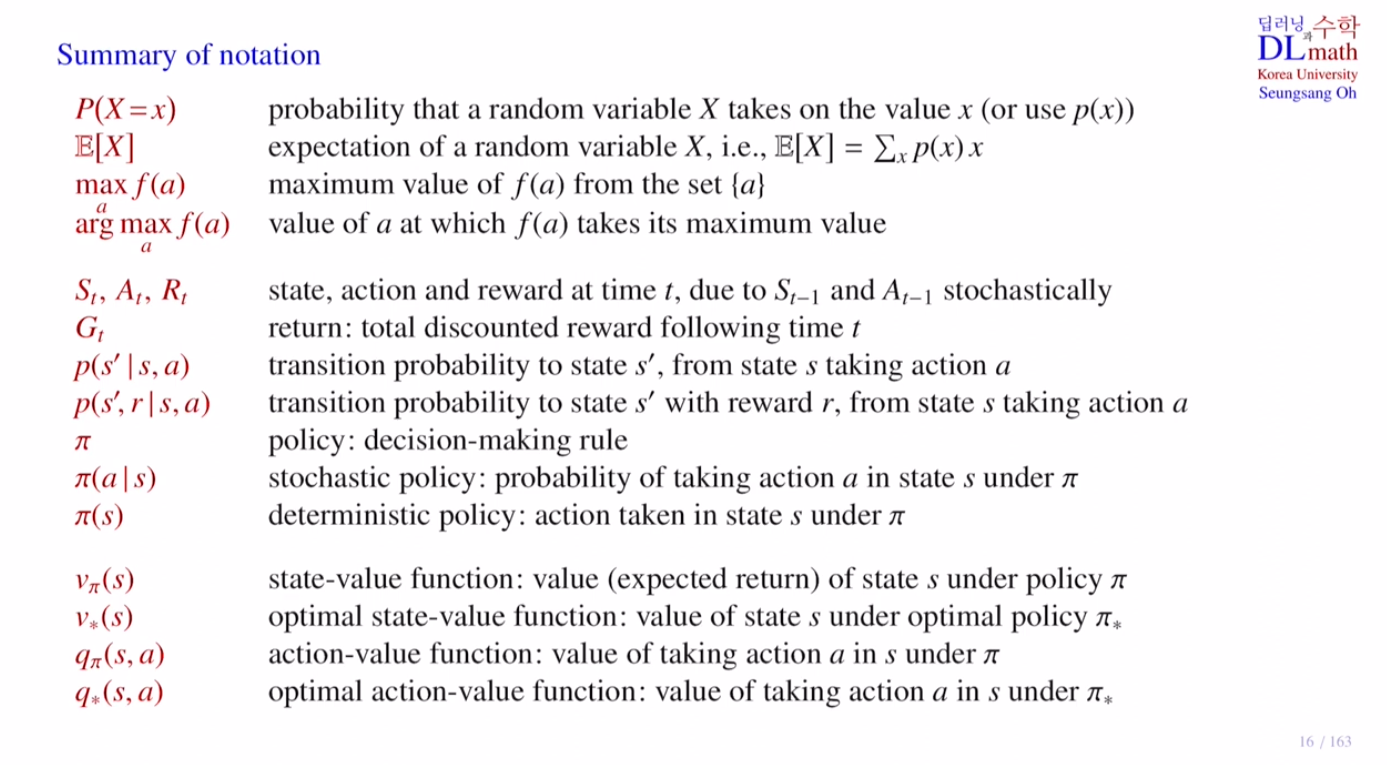
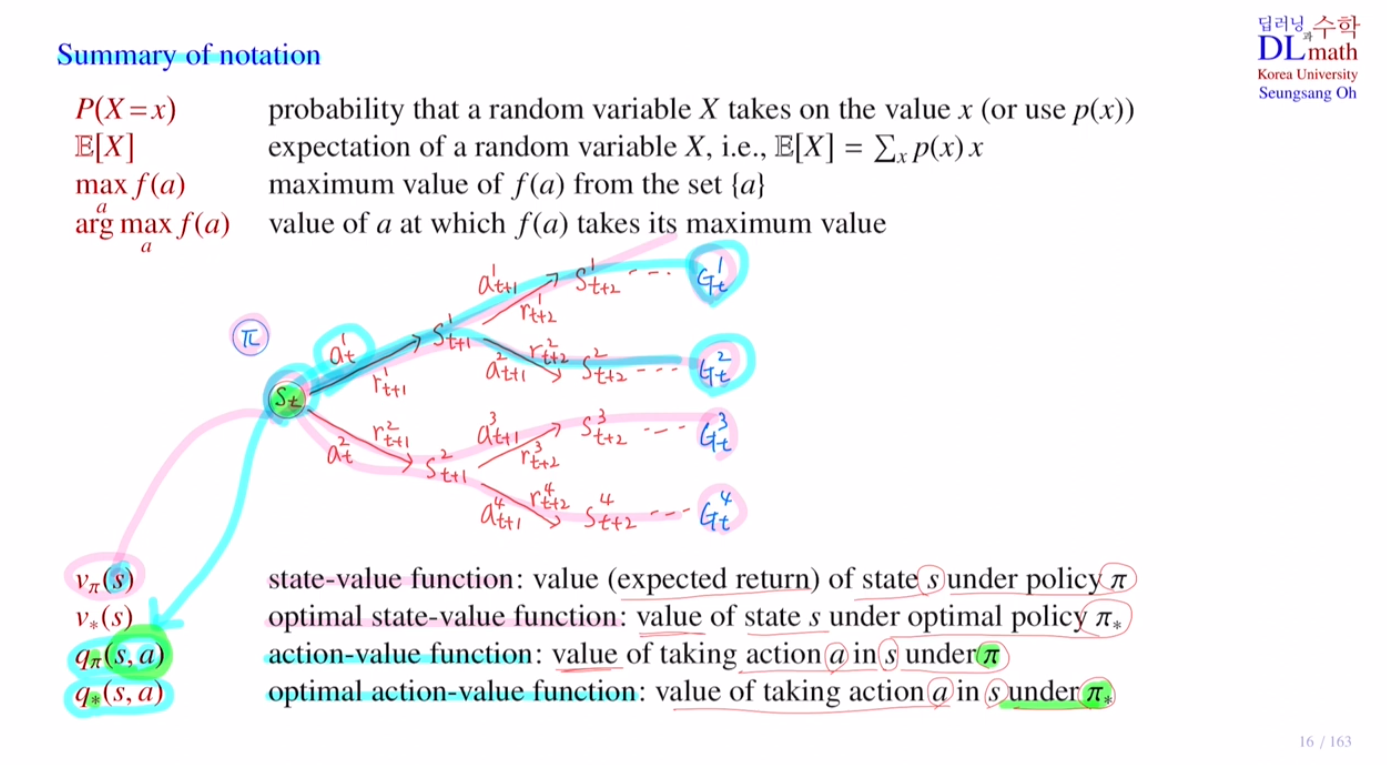
- 는 random variable(확률 변수)를 의미하고, 는 특정 값을 의미한다.
- random variable 가 특정한 값 를 가질 확률
- 간략하게 다음과 같이 표현하기도 한다. →
- random variable 의 expectation(기댓값)
- 집합 에서 의 최대값
- 가 최대값을 가질때의 값 (argument of maximum)
- 시간 에 대한 state, action, reward
- 이는 이전 state 에서 action 을 취했을 때 stochastically 얻어지는 값들이다.
- return
- 시간 이후에 얻어지는 reward들에 대한 total discounted reward
- state transition probability
- 현재 state 에서 action 를 취했을 때, 다음 state가 이 될 확률
- reward까지 고려한 state transition probability
- 현재 state 에서 action 를 취했을 때, 다음 state가 이 되면서 reward가 이 될 확률
- policy (decision-making rule)
- 모든 state에 대해서 어떻게 action을 취할 것인가를 정하는 정책
- stochastic policy
- policy 가 주어져 있을때, state 에서 action 를 취할 확률
- deterministic policy
- policy 가 주어져 있을때, state 에서 취하게될 action
5-1. State-Value function
- Dynamic programming에서 주로 사용
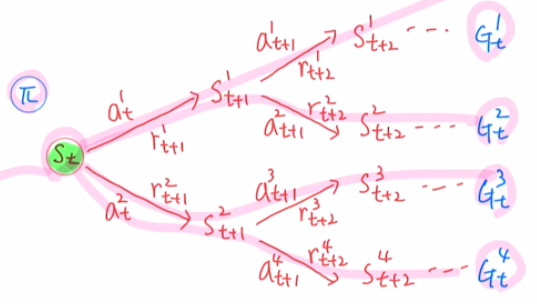
State-Value function
- state-value function (상태-가치 함수)
- policy 가 주어졌을 때, state 이후로 얻게되는 가치(목표)의 기댓값 (expected return)
- optimal state-value function (최적 상태-가치 함수)
- optimal policy 가 주어졌을 때, state 이후로 얻게되는 가치(목표)의 기댓값 (expected return)
5-2. Action-Value function
- Reinforcement Learning에서 주로 사용
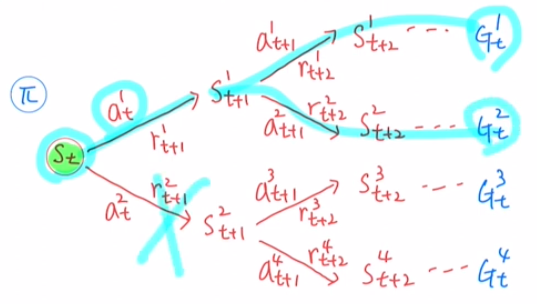
Action-Value function
- action-value function (행동-가치 함수)
- policy 가 주어졌을 때, state 에서 action 를 취한 이후로 얻게되는 가치(목표)의 기댓값 (expected return)
- optimal action-value function (최적 행동-가치 함수)
- optimal policy 가 주어졌을 때, state 에서 action 를 취한 이후로 얻게되는 가치(목표)의 기댓값 (expected return)